Vì sao hệ thống IT chậm lại: mẫu truy vấn N+1 làm web ứng dụng chậm như thế nào
Vấn đề về hiệu năng hệ thống IT thường có vẻ khó lý giải. Người dùng phàn nàn rằng trang web chậm, bảng điều khiển bị lag và API quá thời gian chờ, trong khi CPU và bộ nhớ vẫn có vẻ bình thường. Một nguồn phổ biến gây ra sự chậm tr��� tiềm ẩn này là các truy vấn nhỏ lặp lại. Đây không phải là những báo cáo lớn, phức tạp. Đó là nhiều thao tác tra cứu nhỏ, mỗi thao tác đều thêm một vòng luân chuyển mạng và một lượng công việc cho cơ sở dữ liệu. Trong một lần tải trang, chúng cộng dồn thành nhiều giây chậm trễ.
Bài viết này giải thích lý do các truy vấn nhỏ lặp lại xảy ra, tại sao chúng có hại, và mẫu truy vấn N+1 làm web ứng dụng chậm như thế nào trong thực tế. Bài viết cũng chỉ ra những cách đơn giản để phát hiện sớm vấn đề và khắc phục trước khi nó trở thành nút cổ chai mang tính hệ thống.
Vì sao các truy vấn nhỏ lặp lại tạo ra tải có thể tránh được
Các web ứng dụng hiện đại giao tiếp với cơ sở dữ liệu, cache, chỉ mục tìm kiếm và microservice. Mỗi lời gọi đều có chi phí phát sinh. Ngay cả một truy vấn nhanh trên cơ sở dữ liệu nhanh vẫn cần tuần tự hóa, truyền qua mạng, lập lịch và xử lý kết quả. Khi một endpoint thực hiện mười hoặc một trăm truy vấn tương tự thay vì một truy vấn duy nhất, chi phí phát sinh sẽ nhân lên.
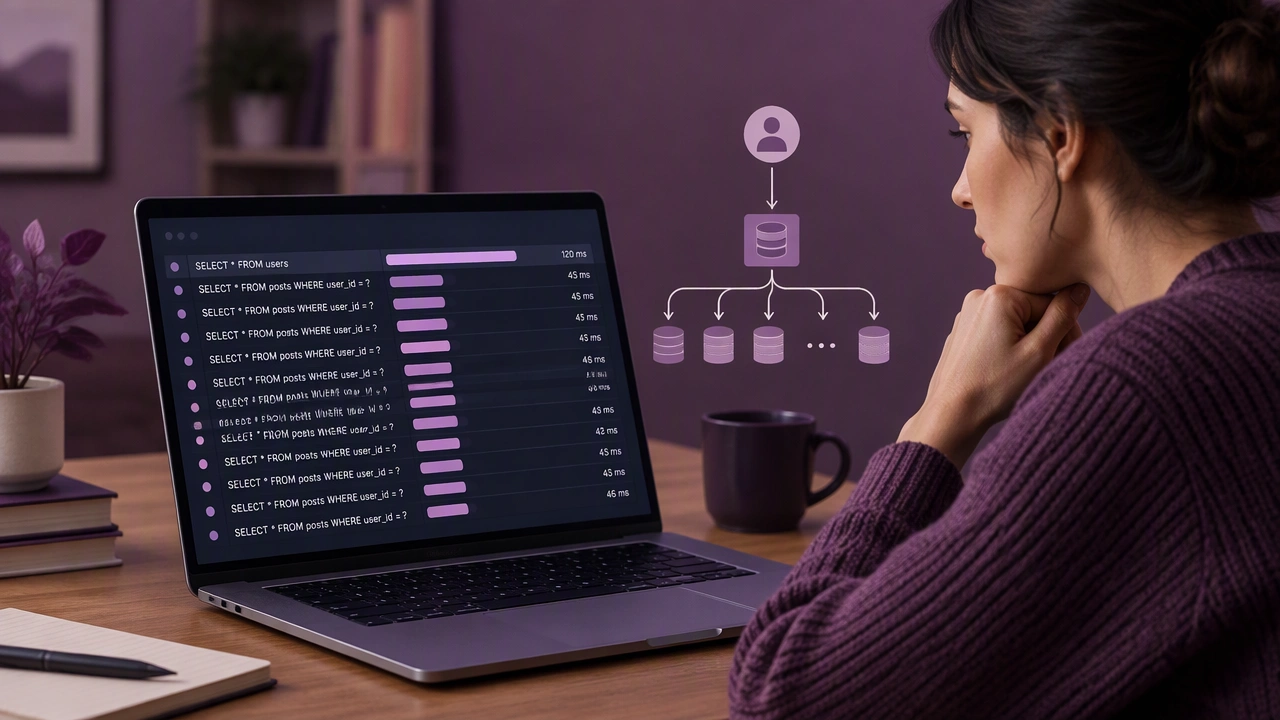
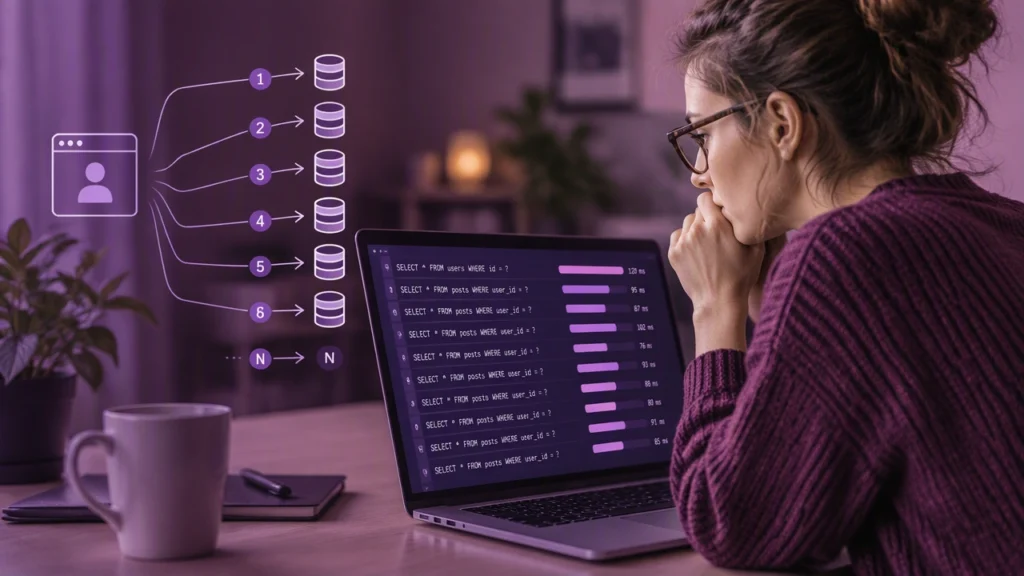
Đây chính là vấn đề cốt lõi của mẫu truy vấn N+1. Ứng dụng tải một danh sách gồm N phần tử, sau đó với mỗi phần tử, nó chạy thêm một truy vấn để lấy dữ liệu liên quan. Kết quả là N+1 vòng luân chuyển thay vì một lời gọi gộp duy nhất. Cơ sở dữ liệu có thể vẫn khỏe mạnh, nhưng ứng dụng dành phần lớn thời gian để chờ mạng và chờ việc phân tích cú pháp, lập kế hoạch lặp lại.
Mẫu này xuất hiện trong mã nguồn thực tế như thế nào
- ORM lazy loading: Nhà phát triển tải một danh sách đơn hàng, sau đó truy cập order.customer trong vòng lặp. Mỗi lần truy cập sẽ kích hoạt một truy vấn để lấy khách hàng.
- Render template: Template lặp qua các bài viết và đọc post.author.name, gây ra một truy vấn cho mỗi tác giả.
- REST hoặc GraphQL resolvers: Một resolver danh sách trả về các phần tử, và mỗi trường lồng nhau chạy truy vấn riêng của nó trong resolver.
- Microservice fan-out: Với mỗi phần tử, ứng dụng gọi một dịch vụ khác để lấy metadata, tạo ra nhiều lời gọi HTTP nhỏ.
Những mẫu này dễ viết và thường hoạt động tốt trong môi trường phát triển với dữ liệu nhỏ. Trong môi trường sản xuất, với hàng trăm hoặc hàng nghìn hàng dữ liệu, chi phí sẽ trở nên rõ ràng.
Vì sao các mẫu này làm web ứng dụng chậm lại
Chi phí không chỉ nằm ở văn bản SQL. Đó là sự kết hợp của nhiều tác động nhỏ cộng dồn lại.
- Chi phí vòng luân chuyển: Mỗi truy vấn đều thêm độ trễ từ mạng và xử lý driver, ngay cả khi cơ sở dữ liệu trả về trong chưa đầy một mili giây.
- Áp lực lên kết nối và luồng: Nhiều truy vấn giữ kết nối và luồng lâu hơn, giảm khả năng đồng thời và tăng thời gian chờ khi có tải.
- Lập kế hoạch và phân tích cú pháp: Cơ sở dữ liệu liên tục phân tích cú pháp và lập kế hoạch cho các câu lệnh tương tự, làm tăng mức sử dụng CPU.
- Tranh chấp khóa và bộ đệm: Nhiều thao tác hơn làm tăng khả năng tranh chấp trên các hàng, trang và cấu trúc nội bộ.
- Cache miss: Các truy vấn nhỏ lặp lại thường không命中 cache cấp ứng dụng vì chúng không được gộp hoặc đặt khóa một cách hiệu quả.
Kết hợp lại, những tác động này làm tăng thời gian phản hồi, giảm thông lượng và khiến việc mở rộng khó hơn. Ứng dụng tiêu tốn nhiều tài nguyên hơn cho cùng một hành động của người dùng.
Cách phát hiện vấn đề sớm
Việc phát hiện vấn đề N+1 sẽ dễ hơn khi bạn đo lường đúng những thứ. Mục tiêu là nhìn thấy các truy vấn tương tự lặp lại trong cùng một request và hiểu được chi phí tích lũy của chúng.
1. Bật ghi log truy vấn kèm ngữ cảnh
Bật log truy vấn cơ sở dữ liệu cho môi trường phát triển và staging. Bao gồm request hoặc trace ID, văn bản truy vấn và thời gian thực hiện. Tìm các cụm câu lệnh tương tự trong cùng một request. Mẫu như nhiều SELECT … WHERE id = ? hoặc WHERE foreign_key = ? là tín hiệu mạnh.
2. Sử dụng công cụ APM hoặc tracing
Các công cụ giám sát hiệu năng ứng dụng có thể gộp truy vấn theo hình dạng và hiển thị số lượng theo endpoint. Nếu một trang chạy cùng một câu lệnh hàng trăm lần, công cụ sẽ chỉ ra điều đó. Distributed tracing cũng có thể cho thấy thời gian dành cho các span cơ sở dữ liệu so với mã ứng dụng.
3. Đếm số truy vấn mỗi request
Thêm một metric đơn giản: tổng số truy vấn được thực hiện trong một request. Hiển thị nó trong môi trường phát triển và staging. Những đột biến đột ngột khi khối lượng dữ liệu tăng thường bộc lộ hành vi N+1.
4. Kiểm tra các câu lệnh tương tự lặp lại
So sánh các văn bản truy vấn chỉ khác nhau ở giá trị tham số. Nếu nhiều truy vấn có cùng cấu trúc và chạy trong vòng lặp, hãy cân nhắc gộp thành batch. Cũng chú ý đến việc đọc lặp lại cùng một bảng trong một request.
5. Kiểm thử tải với dữ liệu thực tế
Chạy kiểm thử với khối lượng giống môi trường sản xuất. Dữ liệu nhỏ che giấu chi phí N+1. Danh sách lớn hơn sẽ lộ ra vì số truy vấn tăng theo số hàng dữ liệu.
Các cách thực tế để giảm tác động
Khi bạn thấy được mẫu này, bạn có thể khắc phục bằng những thay đổi có mục tiêu. Mục tiêu là ít vòng luân chuyển hơn và sử dụng index, cache tốt hơn.
- Eager loading hoặc joins: Lấy dữ liệu liên quan trong một truy vấn bằng JOIN hoặc eager loading của ORM. Cách này thay thế N+1 truy vấn bằng một truy vấn duy nhất trả về các hàng cần thiết.
- Batch queries: Thu thập các ID trong danh sách và chạy một truy vấn WHERE id IN (…) hoặc WHERE foreign_key IN (…). Cách này hữu ích khi join không khả thi.
- Prefetch cho các quan hệ lồng nhau: Với đồ thị sâu hơn, sử dụng prefetch đa tầng để tải các con và cháu trong một số ít truy vấn.
- Result caching: Cache các tra cứu thường gặp như metadata người dùng hoặc sản phẩm. Dùng khóa rõ ràng và TTL ngắn để tránh dữ liệu cũ.
- Read models hoặc materialized views: Với các trang nặng, xây dựng read model tính trước hình dạng cần thiết, giảm số truy vấn khi chạy.
- Streaming và pagination: Tránh tải các danh sách khổng lồ trong một view. Phân trang hoặc stream kết quả để giữ số truy vấn có thể dự đoán được.
Một checklist đơn giản cho code review
- Bộ tải danh sách có lấy dữ liệu liên quan trong một truy vấn không?
- Các vòng lặp có thực hiện truy vấn hoặc lời gọi HTTP cho từng phần tử không?
- Có template nào truy cập các quan hệ chưa được tải không?
- Các resolver có gộp batch hoặc cache các lời gọi liên dịch vụ không?
- Các metric có hiển thị số truy vấn cao cho các endpoint danh sách không?
Khi nào nên tối ưu và khi nào nên chờ
Không phải trường hợp N+1 nào cũng cần hành động ngay. Nếu một endpoint phục vụ danh sách nhỏ với lưu lượng thấp, tác động có thể không đáng kể. Hãy ưu tiên khắc phục ở những nơi số truy vấn tăng theo khối lượng dữ liệu, nơi lưu lượng cao, hoặc nơi mục tiêu độ trễ nghiêm ngặt. Hãy dùng đo lường để định hướng quyết định, không phải phỏng đoán.
Tóm tắt
Các truy vấn nhỏ lặp lại là một nguồn phổ biến và có thể tránh được gây chậm hệ thống IT. Chúng thêm vòng luân chuyển, tăng tranh chấp và lãng phí tài nguyên. Bằng cách hiểu mẫu truy vấn N+1 làm web ứng dụng chậm như thế nào, các nhóm có thể phát hiện vấn đề bằng logging, tracing và các metric đơn giản, sau đó khắc phục bằng eager loading, batching, caching và thiết kế truy cập dữ liệu tốt hơn. Kết quả là các trang nhanh hơn, tải cơ sở dữ liệu thấp hơn và một hệ thống mở rộng trơn tru hơn.