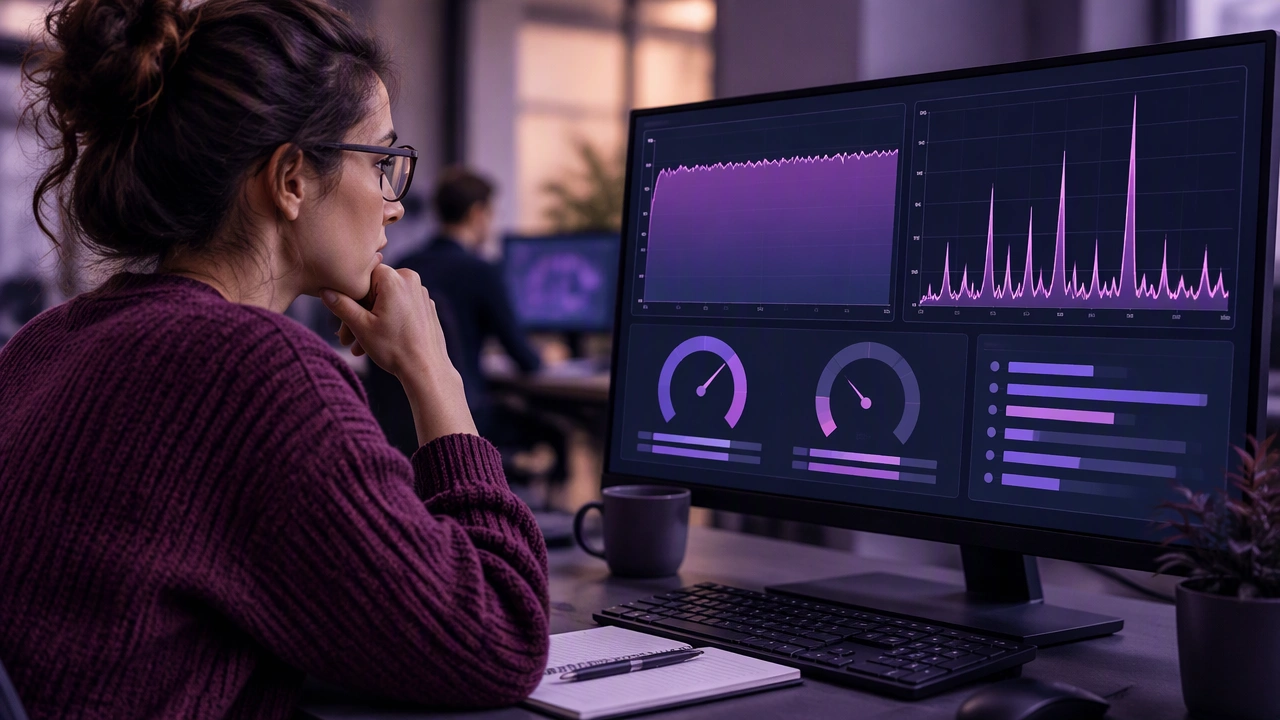
Đỉnh CPU và bão hòa CPU: Vì sao hiệu năng hệ thống chậm lại và cách quan sát
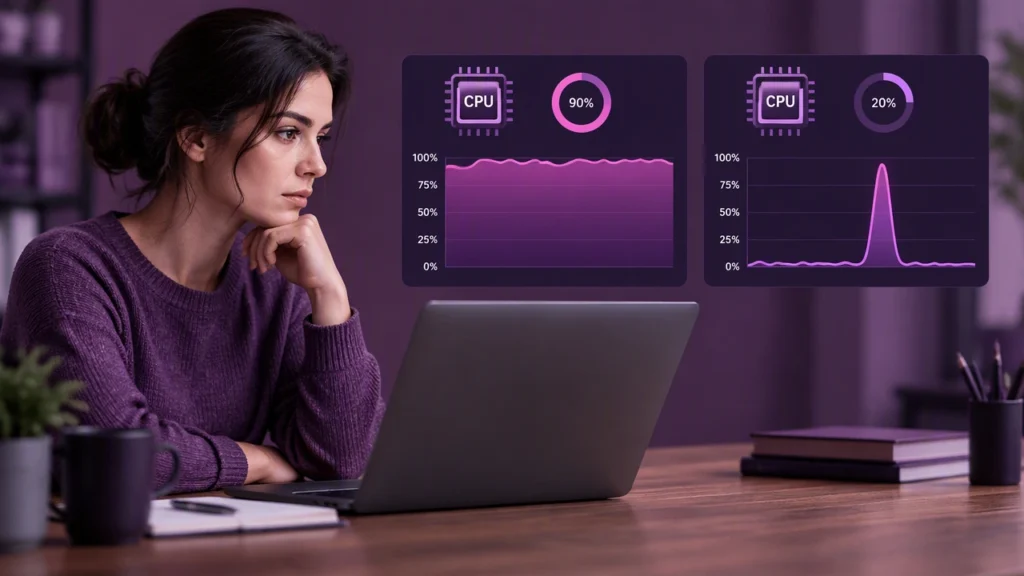
Mỗi ứng dụng chạy chậm đều kể một câu chuyện, và CPU thường nắm giữ manh mối đầu tiên. Tuy nhiên, không phải mọi sự chậm lại đều đến từ cùng một dạng áp lực. Một đợt bùng hoạt động ngắn có thể trông đáng lo nhưng rồi qua đi không để lại hậu quả, trong khi nhu cầu tăng đều đặn có thể âm thầm làm suy giảm dịch vụ trong nhiều phút hoặc nhiều giờ. Trong vận hành IT, khác biệt giữa đỉnh CPU nhất thời và tình trạng bão hòa kéo dài không chỉ mang tính lý thuyết. Nó quyết định bạn đo lường gì, điều tra điều gì và khắc phục điều gì.
Bài viết này giải thích vì sao hệ thống chậm lại, cách phân biệt đỉnh nhất thời với bão hòa và làm rõ sự khác biệt giữa đỉnh CPU và bão hòa CPU kéo dài để xây dựng khả năng quan sát giúp nhận ra cả hai một cách dễ dàng.
Vì sao áp lực CPU lại quan trọng
CPU là tài nguyên dùng chung. Khi nhiều luồng cùng cần chu kỳ xử lý, chúng phải xếp hàng. Một mức xếp hàng nhỏ là bình thường. Xếp hàng sâu hoặc kéo dài thì không. Khi hàng đợi tăng lên, độ trễ yêu cầu tăng, số lần hết thời gian chờ tăng và các dịch vụ phụ thuộc cũng bị ảnh hưởng.
Áp lực CPU có thể đến từ logic ứng dụng, thu gom rác (garbage collection), tuần tự hóa và giải tuần tự hóa dữ liệu, các phép toán mã hóa, công việc cơ sở dữ liệu chạy trên cùng máy chủ, hoặc hiệu ứng “hàng xóm ồn ào” trong môi trường chia sẻ tài nguyên. Nguyên nhân rất quan trọng, nhưng câu hỏi đầu tiên đơn giản hơn: đây là một đợt bùng ngắn hay một mặt bằng cao kéo dài?
Đỉnh CPU thực chất là gì
Đỉnh CPU là mức tăng đột ngột và ngắn hạn của mức sử dụng CPU. Nó thường kéo dài từ vài giây đến vài phút rồi trở lại mức nền. Đỉnh thường xuất hiện khi trượt cache (cache miss), khởi động lạnh (cold start), kích hoạt job hàng loạt, bùng lưu lượng, hoặc các tác vụ đơn lẻ như tạo báo cáo.
Trong lúc đỉnh diễn ra, bạn có thể thấy độ trễ cao hơn ở một số yêu cầu, nhưng hệ thống thường tự phục hồi mà không cần can thiệp. Nguy cơ của đỉnh không nằm ở bản thân đỉnh mà ở mô hình xung quanh nó. Nếu các đỉnh xuất hiện thường xuyên hơn, dồn cụm lại hoặc trùng với thời điểm hệ thống đang chịu áp lực khác, chúng có thể đẩy hệ thống vào trạng thái bão hòa.
Bão hòa CPU kéo dài nghĩa là gì
Bão hòa CPU kéo dài là giai đoạn CPU duy trì ở mức trần hoặc gần trần, thường là 95 đến 100% trên một hoặc nhiều nhân, và hàng đợi ngày càng dài. Bão hòa nghĩa là hệ thống không thể hoàn thành công việc nhanh bằng tốc độ công việc đổ về. Độ trễ tăng, thông lượng có thể chững lại hoặc giảm, và độ trễ ở đuôi phân phối (tail latency) trở nên tệ hơn.
Bão hòa có thể do một tiến trình chạy loạn, một truy vấn được tối ưu kém, một khóa nóng (hot key) trong cache, một nhóm luồng (thread pool) có kích thước quá nhỏ so với tải, hoặc một bản triển khai làm tăng chi phí trên mỗi yêu cầu. Khác với đỉnh, bão hòa thường không tự hết.
Cách phân biệt thực tế
Mấu chốt là quan sát cả mức độ và thời gian kéo dài. Một mẫu đo cao đơn lẻ là chưa đủ. Bạn cần chuỗi dữ liệu theo thời gian và cách mô tả mức độ lấp đầy của CPU so với dung lượng khả dụng.
- Mức độ: Bão hòa thường duy trì gần 100% trên một hoặc nhiều nhân. Đỉnh có thể chạm 100% nhưng thường trên ít nhân hơn và trong khoảng thời gian ngắn hơn.
- Thời gian kéo dài: Đỉnh ngắn và tự giới hạn. Bão hòa kéo dài từ nhiều phút đến nhiều giờ trừ khi bạn thay đổi tải hoặc năng lực xử lý.
- Tín hiệu hàng đợi: Hãy xem độ dài hàng đợi chạy (run queue length) hoặc độ trễ lập lịch (scheduler latency). Bão hòa cho thấy hàng đợi tăng dần. Đỉnh chỉ tạo ra một cú nhô ngắn rồi phục hồi nhanh.
- Dạng đồ thị độ trễ: Khi bão hòa, độ trễ p95 và p99 tăng đều đặn. Khi đỉnh, bạn thường thấy một cụm hẹp độ trễ cao rồi giảm nhanh.
- Chỉ số tương quan: Bão hòa thường đi kèm chuyển ngữ cảnh (context switching) cao, tăng thời gian chờ I/O khi luồng bị chặn và giảm thông lượng trên mỗi đơn vị CPU. Đỉnh có thể không cho thấy các hiệu ứng phụ này.
Nói ngắn gọn, đỉnh là một sự kiện. Bão hòa là một trạng thái. Sự phân biệt này quyết định cách bạn phản ứng.
Vì sao sự khác biệt lại quan trọng khi xử lý
Nếu bạn xử lý mọi đỉnh như bão hòa, bạn có thể dự phòng quá mức, làm hệ thống phức tạp hơn hoặc che lấp vấn đề thực sự. Nếu bạn xử lý bão hòa như một đỉnh, bạn có thể chờ đợi sự phục hồi vốn không bao giờ đến.
- Với đỉnh: Xác nhận tần suất và phạm vi ảnh hưởng. Kiểm tra xem việc thử lại (retry), cache hoặc giới hạn tốc độ có khuếch đại đợt bùng hay không. Cân nhắc làm mượt tải bằng cơ chế lùi dần (backoff) hoặc lập lịch job. Xác thực rằng cơ chế tự động co giãn (autoscaling) không phản ứng với nhiễu.
- Với bão hòa: Giảm nhu cầu hoặc tăng năng lực. Phân tích đường dẫn nóng (hot path). Sửa truy vấn, thuật toán hoặc nhóm luồng. Thêm hoặc chuyển đổi nhân CPU nếu khối lượng công việc thực sự bị giới hạn bởi CPU. Kiểm tra hiệu ứng hàng xóm ồn ào hoặc giới hạn tài nguyên trong container.
Hành động đúng xuất phát từ mô hình bạn quan sát được, chứ không phải từ một chỉ số cao đơn lẻ.
Cách quan sát cả hai bằng khả năng quan sát (observability)
Khả năng quan sát tốt biến chỉ số thô thành bức tranh rõ ràng. Bắt đầu với mức sử dụng CPU ở cấp máy chủ, container và tiến trình. Sau đó bổ sung các tín hiệu bão hòa cho thấy tình trạng xếp hàng, chứ không chỉ mức sử dụng.
Chỉ số cần thu thập
- Mức sử dụng: Mức dùng CPU tổng thể và theo từng nhân, lấy mẫu mỗi 10 đến 30 giây.
- Độ bão hòa: Độ dài hàng đợi chạy, thời gian chờ lập lịch hoặc các chỉ số tương đương của hệ điều hành. Trong container, hãy theo dõi tình trạng bị điều tiết CPU (CPU throttling) và mức sử dụng theo chu kỳ (period usage).
- Hình dạng tải: Tốc độ yêu cầu, tỷ lệ lỗi và các phân vị độ trễ của dịch vụ.
- Tín hiệu tiến trình: Các tiến trình hoặc luồng tiêu thụ CPU hàng đầu, thời gian dừng do thu gom rác và tỷ lệ chuyển ngữ cảnh.
Cách phân tích
- Dùng nhiều cửa sổ thời gian: So sánh giá trị trung bình 1 phút, 5 phút và 15 phút. Đỉnh sẽ mờ dần trong cửa sổ dài hơn. Bão hòa vẫn tồn tại.
- Đặt hai ngưỡng: Một ngưỡng cảnh báo (ví dụ: duy trì 80% trên các nhân trong năm phút) và một ngưỡng nghiêm trọng (ví dụ: duy trì 95% kèm theo độ trễ p99 tăng).
- Tương quan: Chồng đồ thị CPU với độ trễ, tỷ lệ lỗi và mốc triển khai. Nếu bão hòa trùng với phiên bản mới, thay đổi đó có khả năng là nguyên nhân.
- Kiểm tra theo từng nhân: Một nhân nóng duy nhất có thể làm nghẽn thành phần đơn luồng trong khi mức sử dụng tổng thể trông vẫn vừa phải.
Cần làm gì khi phát hiện
- Nếu là đỉnh: Xác nhận rằng nó hiếm và ngắn. Kiểm tra rằng cơ chế thử lại và cầu dao (circuit breaker) hoạt động tốt. Kiểm tra thời gian nghỉ (cooldown) của autoscaling để tránh dao động liên tục.
- Nếu là bão hòa: Phân tích hiệu năng (profile). Tìm hàm hoặc truy vấn nóng. Điều chỉnh kích thước nhóm luồng cho phù hợp. Cân nhắc dùng cache hoặc tính toán trước. Mở rộng theo chiều ngang nếu khối lượng công việc có thể song song hóa, hoặc theo chiều dọc nếu không.
Mô hình tư duy thực tế
Hãy hình dung CPU như một đường cao tốc. Đỉnh là một đợt xe dồn lên ở đoạn nhập làn. Giao thông chậm lại trong chốc lát rồi thông thoáng trở lại. Bão hòa là đoạn đường dài luôn kín xe và xe mới liên tục đổ về. Hàng xe nối dài, thời gian di chuyển tăng và ùn tắc lan rộng. Nhiệm vụ của bạn là quan sát đủ lâu để biết mình đang gặp trường hợp nào, rồi hành động cho phù hợp.
Những sai lầm phổ biến cần tránh
- Tính trung bình quá mức: Giá trị trung bình một giờ che lấp cả đỉnh và bão hòa. Hãy dùng nhiều cửa sổ thời gian.
- Bỏ qua góc nhìn theo từng nhân: Mức sử dụng tổng thể có thể gây hiểu lầm trong khối lượng công việc hỗn hợp hoặc đơn luồng.
- Chạy theo tín hiệu sai: Tự động co giãn chỉ dựa trên CPU có thể dao động liên tục. Hãy kết hợp CPU với độ trễ và độ sâu hàng đợi.
- Quên mất tải công việc: CPU chỉ là phương tiện, không phải mục đích. Luôn gắn hành vi CPU với độ trễ và thông lượng mà người dùng cảm nhận.
Kết luận chính
- Đỉnh CPU ngắn và thường tự phục hồi. Bão hòa CPU kéo dài là trạng thái dai dẳng làm suy giảm dịch vụ cho đến khi bạn thay đổi tải hoặc năng lực.
- Hãy dùng cả chỉ số mức sử dụng và chỉ số bão hòa để phân biệt chúng.
- Đưa ra phản ứng dựa trên thời gian kéo dài, tình trạng xếp hàng và tác động đến độ trễ, chứ không phải một chỉ số cao đơn lẻ.
- Xây dựng khả năng quan sát cho thấy chi tiết theo từng nhân và từng tiến trình, với nhiều cửa sổ thời gian và ngưỡng rõ ràng.
Khi bạn nhìn rõ sự khác biệt, bạn sẽ ngừng phản ứng với nhiễu và bắt đầu giải quyết đúng vấn đề. Đó là cách giữ cho hệ thống IT phản hồi tốt dưới áp lực thực tế.