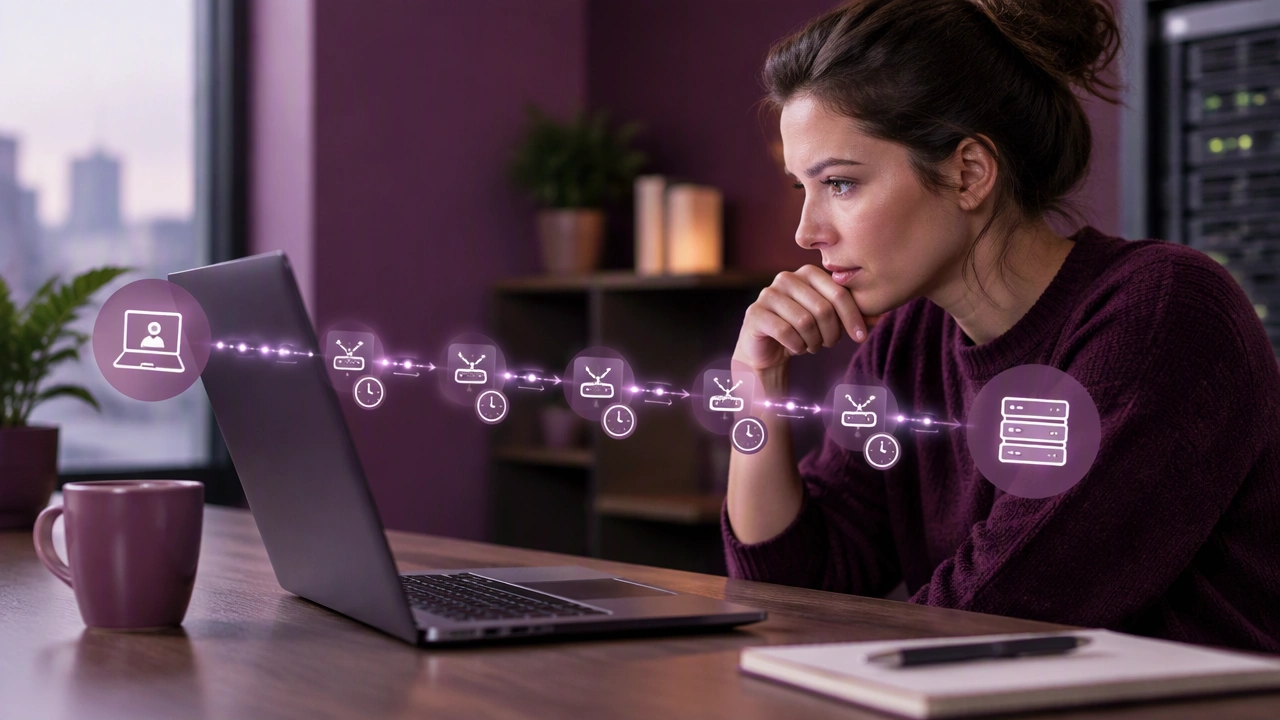
Hiệu năng hệ thống và thuế ẩn: Vì sao độ trễ mạng nhỏ nhân lên trên mọi yêu cầu
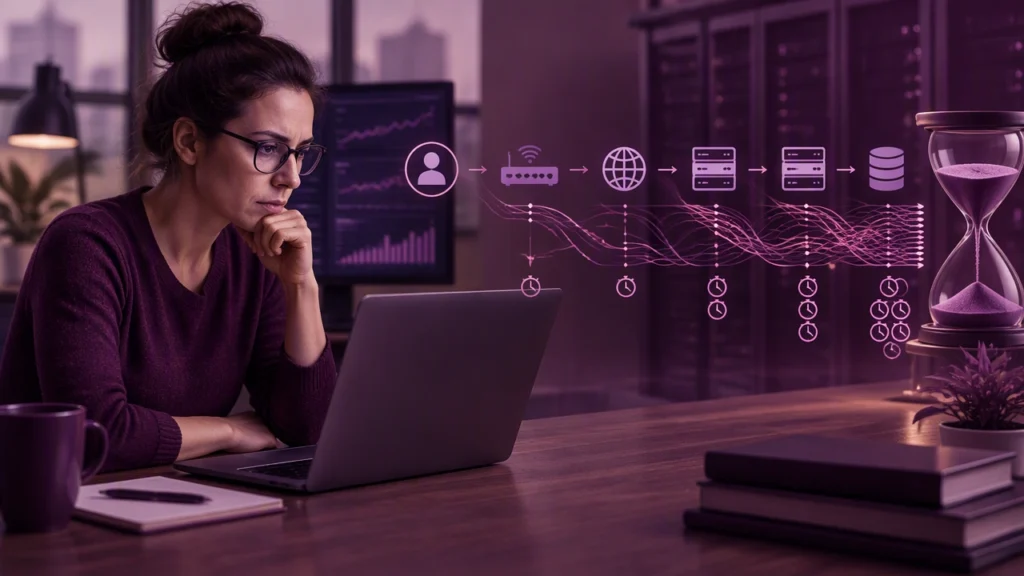
Các ứng dụng hiện đại hiếm khi chạy trên một máy chủ duy nhất. Một yêu cầu người dùng thường đi qua máy chủ web, cổng API, một hoặc nhiều microservice, cơ sở dữ liệu, bộ nhớ đệm, nhà cung cấp định danh và một số API bên thứ ba. Mỗi bước chuyển này đều vượt qua một ranh giới mạng, và mỗi ranh giới lại tạo ra độ trễ. Kết quả là một mô hình âm thầm làm suy giảm hiệu suất IT: những độ trễ nhỏ, riêng lẻ tưởng như chấp nhận được, tích lũy thành sự chậm trễ rõ rệt ảnh hưởng đến người dùng, doanh thu và độ tin cậy.
Đây là lý do vì sao cách độ trễ mạng cộng thêm chi phí ẩn cho mọi yêu cầu người dùng là một trong những câu hỏi quan trọng nhất đối với các nhóm platform, SRE và kỹ sư backend. Sự chậm lại không phải lúc nào cũng do một thành phần bị lỗi. Nó thường xuất phát từ hiệu ứng cộng dồn của nhiều lần chờ đợi nhỏ.
Vì sao độ trễ mạng nhỏ lại có cảm giác lớn hơn thực tế
Độ trễ mạng thường được đo bằng mili giây và nhiều nhóm coi nó là không đáng kể. Độ trễ 2 ms giữa hai dịch vụ nghe có vẻ nhỏ khi xét riêng lẻ. Nhưng các luồng hướng tới người dùng hiện nay không hề đơn lẻ. Chúng là chuỗi phụ thuộc. Nếu việc hiển thị một trang cần năm lệnh gọi dịch vụ tuần tự, và mỗi lệnh gọi cộng thêm 2 ms thời gian mạng cộng với xử lý, riêng phần mạng đã trở nên đáng kể. Nếu năm lệnh gọi đó còn phân nhánh tới các phụ thuộc khác, tổng thời gian mạng lại tăng thêm.
Có một số lý do khiến độ trễ nhỏ nhân lên rất nhanh:
- Phụ thuộc tuần tự: Khi dịch vụ B chờ dịch vụ A, và dịch vụ C chờ dịch vụ B, độ trễ mạng sẽ cộng dồn dọc theo chuỗi.
- Mô hình phân nhánh (fan-out): Một yêu cầu duy nhất có thể gọi nhiều dịch vụ song song. Dù mỗi lệnh gọi chỉ thêm vài mili giây, độ trễ tổng thể thường bị giới hạn bởi lệnh gọi chậm nhất.
- Thử lại và timeout: Khi một lệnh gọi chậm hoặc thất bại, việc thử lại tạo thêm các vòng khứ hồi mạng và kéo dài độ trễ ở phần đuôi phân phối.
- Hạ tầng dùng chung: Switch mạng, bộ cân bằng tải và proxy đều thêm độ trễ nhỏ trên mỗi hop và độ trễ này tăng theo khối lượng yêu cầu.
- Đường đi lạnh (cold paths): Tra cứu DNS, bắt tay TLS và thiết lập kết nối có thể thêm hàng chục hoặc hàng trăm mili giây cho yêu cầu đầu tiên hoặc sau thời gian nhàn rỗi.
Những tác động này thường vô hình khi chỉ nhìn vào giá trị trung bình đơn giản. Hệ thống có thể trông vẫn khỏe mạnh trên dashboard hiển thị thời gian phản hồi trung bình, trong khi người dùng lại trải nghiệm tải trang chậm do phần đuôi dài của phân phối.
Độ trễ ẩn ở đâu trong một yêu cầu điển hình
Để thấy rõ chi phí ẩn, cần lần theo dấu vết thời gian mạng xuất hiện ở đâu trong một yêu cầu web điển hình.
- Từ client đến biên (edge): Trình duyệt hoặc ứng dụng di động kết nối tới CDN hoặc bộ cân bằng tải. Độ trễ ở đây phụ thuộc vào vị trí địa lý, chất lượng chặng cuối và quá trình đàm phán TLS.
- Từ biên đến máy chủ ứng dụng: Yêu cầu đi vào mạng nội bộ. Đường đi này có thể bao gồm nhiều thiết bị mạng và lớp ảo hóa.
- Từ ứng dụng đến service mesh: Trong môi trường Kubernetes hoặc service mesh, sidecar hoặc ingress controller tạo thêm các hop trung gian.
- Từ dịch vụ đến cơ sở dữ liệu hoặc cache: Kết nối tới cơ sở dữ liệu thường vượt qua các vùng sẵn sàng hoặc subnet khác nhau, tạo thêm độ trễ ngay cả khi ở cùng trung tâm dữ liệu.
- Từ dịch vụ đến API bên thứ ba: Các lệnh gọi bên ngoài nằm ngoài tầm kiểm soát của bạn. Độ trễ của chúng thay đổi và có thể tăng đột biến không báo trước.
Mỗi hop riêng lẻ đều nhỏ. Nhưng cộng lại, chúng tạo thành khoản thuế ẩn cho mọi yêu cầu người dùng.
Vì sao giá trị trung bình che giấu vấn đề
Vấn đề về độ trễ thường là vấn đề ở phần đuôi phân phối. Nếu 95% yêu cầu hoàn thành trong 120 ms nhưng 5% mất 800 ms, nhiều người dùng vẫn có trải nghiệm kém. Giá trị trung bình và thậm chí trung vị có thể che lấp điều này. Độ trễ đuôi dài thường do:
- Tạm dừng do thu gom rác (GC) khiến kết nối bị giữ mở
- Cạn kiệt pool kết nối buộc phải thiết lập TCP hoặc TLS mới
- Tắc nghẽn mạng trên các liên kết dùng chung
- Phụ thuộc chậm thỉnh thoảng gây timeout
- Mất gói tin hoặc truyền lại trên đường truyền không ổn định
Vì những nguyên nhân này xuất hiện ngắt quãng, chúng thể hiện rõ trong phân phối theo phân vị nhưng lại khó thấy khi chỉ nhìn trung bình đơn giản.
Cách quan sát độ trễ mạng một cách rõ ràng
Để quan sát độ trễ cần đo lường ở nhiều tầng. Mục tiêu là tách thời gian mạng khỏi thời gian xử lý và theo dõi cả hai ở từng hop cũng như trên toàn bộ hành trình.
1. Đo lường ở cấp dịch vụ
Mỗi dịch vụ nên ghi lại thời gian chờ các lệnh gọi tới dịch vụ phụ thuộc. Bao gồm thời gian kết nối, thời gian đến byte đầu tiên và tổng thời lượng lệnh gọi. Các chỉ số này nên được gắn nhãn theo dịch vụ đích, thao tác và mã trạng thái.
2. Sử dụng tracing phân tán
Tracing giúp chuỗi phụ thuộc trở nên trực quan. Một trace duy nhất cho thấy thời gian được tiêu tốn ở đâu trên các dịch vụ và ranh giới mạng. Trace đặc biệt hữu ích để nhận diện các mô hình phân nhánh và đường đi chậm vốn khó phát hiện trong các chỉ số tổng hợp.
3. Ghi lại thời gian DNS, TCP và TLS
Nhiều nhóm chỉ đo tổng thời gian yêu cầu. Để thấy rõ độ trễ mạng, hãy ghi lại thời gian phân giải DNS, thời gian kết nối TCP và thời gian bắt tay TLS. Những giá trị này giải thích độ trễ khi khởi động lạnh và tình trạng chậm ngắt quãng do luân chuyển kết nối.
4. Theo dõi phân phối theo phân vị
Theo dõi p50, p95, p99 và p99.9 cho độ trễ yêu cầu và cho từng lệnh gọi tới dịch vụ phụ thuộc. Các chỉ số ở đuôi phân phối sẽ phơi bày chi phí ẩn mà giá trị trung bình che giấu.
5. Đo tín hiệu ở tầng mạng
Bổ sung chỉ số ứng dụng bằng chỉ số mạng: mất gói tin, truyền lại, lỗi giao diện, mức sử dụng liên kết và rớt bộ đệm. Những tín hiệu này thường tương quan với các đỉnh độ trễ trong log ứng dụng.
6. Thêm giám sát tổng hợp (synthetic)
Các bài kiểm tra synthetic chạy từ nhiều vị trí và đo độ trễ đầu-cuối mà không phụ thuộc vào lưu lượng người dùng thực. Chúng cung cấp đường cơ sở và có thể phát hiện vấn đề theo khu vực hoặc theo đường truyền cụ thể.
Kỹ thuật thực tế để giảm chi phí ẩn
Khi đã quan sát được độ trễ, bạn có thể giảm thiểu nó. Các chiến lược hiệu quả nhất tập trung vào việc cắt giảm các vòng khứ hồi không cần thiết và làm cho những vòng còn lại nhanh và ổn định hơn.
- Gộp và hợp nhất lệnh gọi: Giảm số hop mạng bằng cách kết hợp các thao tác liên quan.
- Cache mạnh ở biên: Phục vụ nội dung lặp lại từ vị trí gần người dùng hơn.
- Tái sử dụng kết nối: Duy trì keep-alive, ghép kênh HTTP/2 và pooling kết nối để tránh chi phí thiết lập TCP và TLS lặp lại.
- Đưa tính toán lại gần dữ liệu: Giảm các lệnh gọi xuyên vùng hoặc xuyên khu vực khi logic nhạy với độ trễ phụ thuộc vào một tập dữ liệu cụ thể.
- Đặt timeout và ngân sách thời gian thực tế: Truyền ngân sách thời gian dọc theo chuỗi lệnh gọi để một phụ thuộc chậm không chiếm hết toàn bộ ngân sách yêu cầu.
- Sử dụng circuit breaker và phương án dự phòng: Ngăn các đường đi chậm chặn các công việc không liên quan.
- Tối ưu DNS và TLS: Sử dụng cache DNS cục bộ, phiên TLS dài hạn và bộ mã hóa hiện đại để giảm chi phí bắt tay.
Ví dụ ngắn
Hãy xét một luồng thanh toán gọi tới năm dịch vụ nội bộ và hai API bên thứ ba. Trong môi trường production, thời gian phản hồi trung bình trông vẫn ổn. Tuy nhiên, p99 lại cao. Sau khi bổ sung tracing và đo thời gian DNS/TCP/TLS, nhóm phát hiện một dịch vụ nội bộ thỉnh thoảng mở kết nối cơ sở dữ liệu mới do pool đã cạn. Mỗi kết nối mới làm phát sinh bắt tay TCP và thiết lập TLS, cộng thêm tra cứu DNS khi endpoint cơ sở dữ liệu được phân giải lại. Thời gian mạng bổ sung tuy nhỏ trên mỗi lệnh gọi, nhưng lại xảy ra ở những yêu cầu chậm nhất, đẩy chúng vào phần đuôi dài. Bằng cách tăng kích thước pool kết nối, tái sử dụng kết nối nhất quán hơn và cache kết quả DNS cục bộ, nhóm đã giảm đáng kể độ trễ p99 mà không cần thay đổi logic nghiệp vụ.
Kết luận chính
- Độ tr��� mạng nhỏ nhân lên qua các phụ thuộc và trở thành chi phí ẩn cho mọi yêu cầu người dùng.
- Giá trị trung bình thường che giấu độ trễ đuôi dài. Hãy dùng phân phối theo phân vị để thấy trải nghiệm người dùng thực tế.
- Kết hợp đo lường dịch vụ, trace và chỉ số mạng để tách thời gian mạng khỏi thời gian xử lý.
- Giảm số vòng khứ hồi, tái sử dụng kết nối và đưa công việc lại gần dữ liệu để cắt giảm độ trễ từ gốc.
Độ trễ mạng không chỉ là chi tiết cấp thấp. Nó là yếu tố cốt lõi quyết định hiệu suất vận hành và trải nghiệm người dùng. Bằng cách đo lường cẩn thận và giảm các hop không cần thiết, các nhóm có thể loại bỏ khoản thuế ẩn ảnh hưởng đến mọi yêu cầu mà hệ thống của họ xử lý.