Flame Graphs: Biến Dữ Li��u Thô Thành Bản Đồ Thời Gian Hiệu Năng Hệ Thống
Vấn đề hiệu năng thường xuất hiện dưới dạng lời phàn nàn mơ hồ: dịch vụ chậm chạp, báo cáo mất quá lâu, hoặc độ trễ tăng sau một bản phát hành. Phần khó không phải là nhận ra r��ng mọi thứ chậm; mà là tìm ra thời gian đi đâu. Hướng dẫn người mới đọc sơ đồ ngọn lửa để tìm đường mã chậm này giải thích cách sampling biến các quan sát thô thành một bản đồ rõ ràng về hoạt động CPU và cách sử dụng bản đồ đó mà không cần đoán mò.
Tại sao hệ thống chậm lại
Một chương trình chậm lại khi công việc mất nhiều thời gian hơn dự kiến. Công việc đó có thể bị hạn chế bởi CPU, chẳng hạn như phân tích cú pháp, mã hóa hoặc sắp xếp. Nó có thể đang chờ I/O, khóa hoặc lệnh gọi mạng. Nó cũng có thể do lập lịch kém, áp lực bộ nhớ, thu gom rác hoặc tranh chấp giữa các luồng. Triệu chứng thường gặp hiếm khi chỉ thẳng đến nguyên nhân, vì vậy kỹ sư cần bằng chứng kết nối một yêu cầu với đoạn mã đã tiêu tốn thời gian.
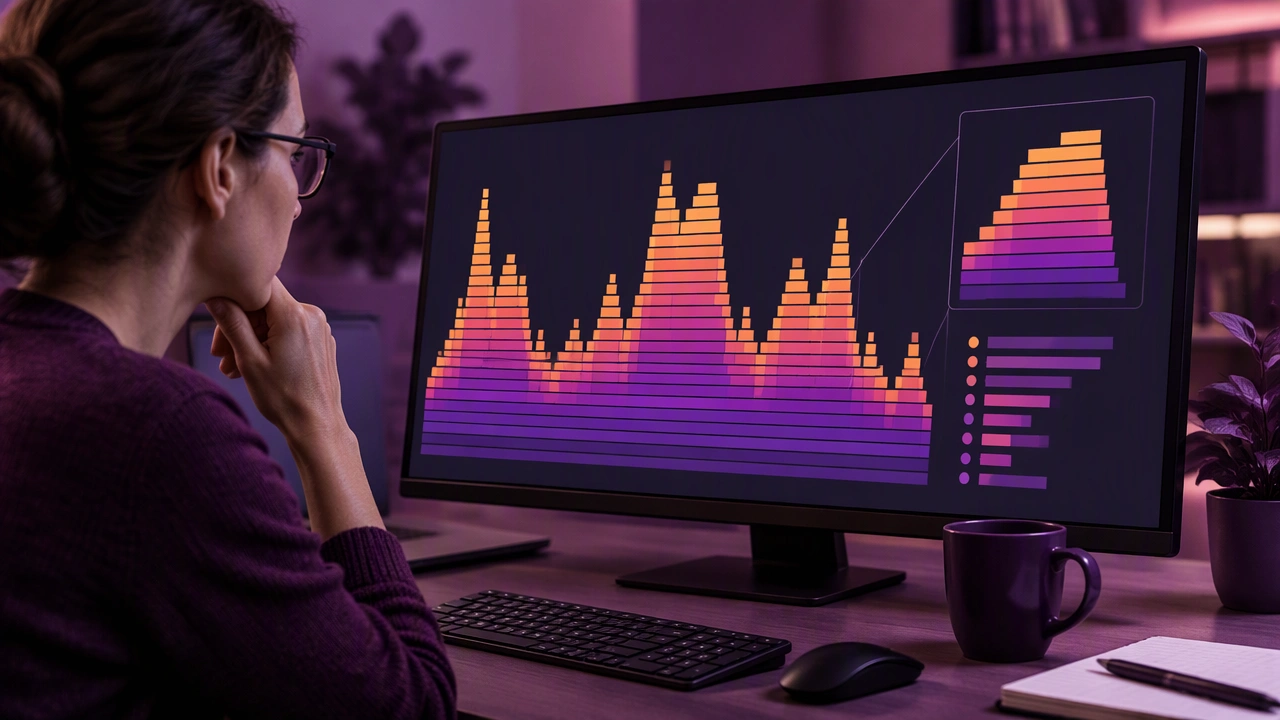
Các công cụ profiling thu thập bằng chứng đó bằng cách sampling chương trình trong khi nó chạy. Thay vì theo dõi từng lệnh, một sampler ghi lại stack trace theo khoảng thời gian. Qua nhiều mẫu, các đường được thực thi thường xuyên xuất hiện nhiều hơn. Sơ đồ ngọn lửa tổ chức các mẫu đó để chiều rộng đại diện cho thời gian tương đối và chiều cao đại diện cho độ sâu gọi. Kết quả là một cái nhìn tổng quan về nơi quá trình dành sự chú ý.
Từ mẫu đến bản đồ
Sơ đồ ngọn lửa được xây dựng từ các stack trace. Mỗi trace là một chuỗi các lệnh gọi hàm đang hoạt động, từ điểm nhập xuống hàm đang chạy khi mẫu được lấy. Công cụ đếm tần suất mỗi stack xuất hiện, sau đó hợp nhất các tiền tố chung thành một cây. Mỗi hình chữ nhật là một hàm hoặc frame. Chiều rộng của nó hiển thị tỷ lệ mẫu bao gồm frame đó, và chiều cao hiển thị vị trí của nó trong ngăn xếp gọi.
Chiều rộng là ý tưởng chính. Một frame rộng không nhất thiết có nghĩa là hàm đó chậm một cách cô lập; nó có nghĩa là một tỷ lệ lớn mẫu đã đi qua nó. Frame đó có thể đang tự thực hiện công việc, hoặc nó có thể chỉ gọi một child rộng. Do đó, đọc sơ đồ có nghĩa là so sánh một frame với các child của nó thay vì nhìn vào một thanh duy nhất một cách cô lập.
Cách đọc sơ đồ
Bắt đầu từ đầu biểu đồ, nơi các hàm lá xuất hiện. Đây là các frame đang thực thi khi các mẫu được chụp. Tìm các lá rộng, vì chúng thường tiết lộ các vòng lặp nóng, tuần tự hóa, nén hoặc các lệnh gọi thư viện tốn kém. Sau đó, theo đường đi xuống để xem lệnh gọi nào dẫn đến đó. Một lá rộng dưới parent hẹp có thể chỉ ra chi phí tập trung; một đường rộng từ trên xuống dưới gợi ý rằng toàn bộ chuỗi gọi đang hoạt động.
Chú ý đến đệ quy v�� các helper lặp lại. Khi cùng một hàm xuất hiện ở nhiều nơi, sơ đồ có thể hiển thị nhiều hình chữ nhật với tên tương tự. Các quy tắc hợp nhất và inline cũng có thể thay đổi hình dạng, vì vậy hãy so sánh cấu trúc trực quan với ngữ cảnh gọi thay vì giả định rằng mỗi hình chữ nhật là một tệp nguồn riêng biệt.
Màu sắc không phải là ngôn ngữ phổ quát trong sơ đồ ngọn lửa. Một số công cụ sử dụng màu ấm cho thời gian CPU và màu mát cho thời gian chờ, trong khi những công cụ khác chỉ sử dụng màu để phân biệt các frame. Kiểm tra chú giải trước khi đưa ra kết luận. Cách diễn giải an toàn nhất dựa trên chiều rộng, độ sâu và phương pháp sampling.
Đọc để tìm đường mã chậm
Sử dụng một trình tự đơn giản khi điều tra một yêu cầu chậm:
- Thiết lập baseline. Xác nhận cửa sổ mẫu, quy trình và loại yêu cầu. Một sơ đồ từ công việc nền sẽ không giải thích được sự tăng vọt độ trễ API.
- Tìm các đường rộng nhất. Xác định các frame chiếm tỷ lệ đáng kể trong tổng mẫu, đặc biệt gần các lá.
- Theo lệnh gọi lên trên. Theo đường đi từ lá nóng đến điểm nhập để hiểu tính năng hoặc quy trình nào sở hữu chi phí.
- Phân biệt self time và total time. Một frame có tổng chiều rộng lớn có thể là container; chi phí có thể thuộc về các child của nó.
- So sánh các kịch bản. Chụp sơ đồ trước và sau khi thay đổi, hoặc so sánh các giai đoạn khỏe mạnh và suy giảm, sử dụng cùng một khối lượng công việc.
Ví dụ, một lá json_decode rộng dưới một request handler gợi ý rằng việc phân tích đang tiêu tốn một tỷ lệ lớn mẫu. Câu hỏi tiếp theo là liệu payload có bất thường lớn, handler có đang phân tích lặp lại, hay một thư viện có đang thực hiện công việc có thể tránh được. Sơ đồ tự nó không trả lời câu hỏi đó, nhưng nó cung cấp một vị trí chính xác để điều tra.
Các cách đọc sai thường gặp
Sơ đồ ngọn lửa không phải là biểu đồ thời gian. Chúng không hiển thị thứ tự sự kiện, và một frame rộng không chứng minh rằng một hàm đã gây ra mọi yêu cầu chậm. Sampling cũng có giới hạn: các hàm rất ngắn có thể bị bỏ sót, và thời gian chờ chặn có thể bị đánh giá thấp nếu sampler chỉ ghi CPU stack. Diễn giải sơ đồ cùng với các chỉ số độ trễ, nhật ký và, khi cần, một chế độ profiling khác.
Một cái bẫy khác là tối ưu hóa một frame chỉ rộng vì nó gọi nhiều child. Refactor một parent mà không thay đổi các child của nó có thể không tạo ra cải thiện nào. Ngược lại, một frame hẹp có thể rất quan trọng nếu nó chạy trên đường quan trọng hoặc giữ một khóa. Ngữ cảnh quyết định mức độ ưu tiên.
Biến bản đồ thành hành động
Một profile hữu ích dẫn đến một giả thuyết nhỏ, có thể kiểm chứng được. Giảm kích thước payload, lưu trữ bộ nhớ đệm một phép tính lặp lại, thay đổi thuật toán, chuyển công việc ra khỏi đường yêu cầu, hoặc loại bỏ một khóa không cần thiết. Sau khi thay đổi, thu thập một profile mới dưới tải tương đương và so sánh chiều rộng. Nếu đường nóng co lại và độ trễ cải thiện, bằng chứng là mạnh mẽ. Nếu hình dạng không thay đổi, nút thắt ở nơi khác.
Sơ đồ ngọn lửa không thay thế sự phán đoán của kỹ sư. Chúng làm cho sự phán đoán tốt hơn bằng cách hiển thị thời gian tập trung ở đâu, lệnh gọi nào quan trọng, và giải thích nào đáng được đo lường. Đọc bản đồ một cách kiên nhẫn, xác minh mỗi kết luận bằng một tín hiệu khác, và để các mẫu hướng dẫn thí nghiệm tiếp theo.